Warum beginnen die großen Anbieter künstlicher Intelligenz, unsichtbare Wasserzeichen in ihre Inhalte einzubetten? Die erste Antwort scheint auf der Hand zu liegen: um die KI-Verordnung einzuhalten. Sie stimmt, aber sie ist unvollständig.
Die naheliegende Antwort: Artikel 50 der KI-Verordnung
Artikel 50 der europäischen Verordnung verlangt von Anbietern von Systemen, die Text, Bild, Ton oder Video erzeugen, ihre Erzeugnisse erkennbar und gekennzeichnet zu machen, in einem maschinenlesbaren Format. Die Pflicht betrifft keinen sichtbaren Hinweis auf dem Bildschirm; sie betrifft ein Signal, das weiter unten in der Kette von jedem Beteiligten automatisch ausgewertet werden kann.
Die Vorstöße der großen Anbieter fügen sich klar in diese Linie. Anthropic bettet nun ein statistisches Signal in bestimmte von Claude erzeugte Texte ein. OpenAI nutzt unter anderem C2PA-Metadaten und SynthID-Wasserzeichen für bestimmte Bild- und Toninhalte, mit dem Ziel, diese Herkunftssignale auf weitere Formate auszudehnen.
Das Web ist zugleich Quelle und Abfluss geworden
Das Wasserzeichen auf eine regulatorische Formalität zu verkürzen, hieße womöglich, eine tiefere Frage zu verfehlen.
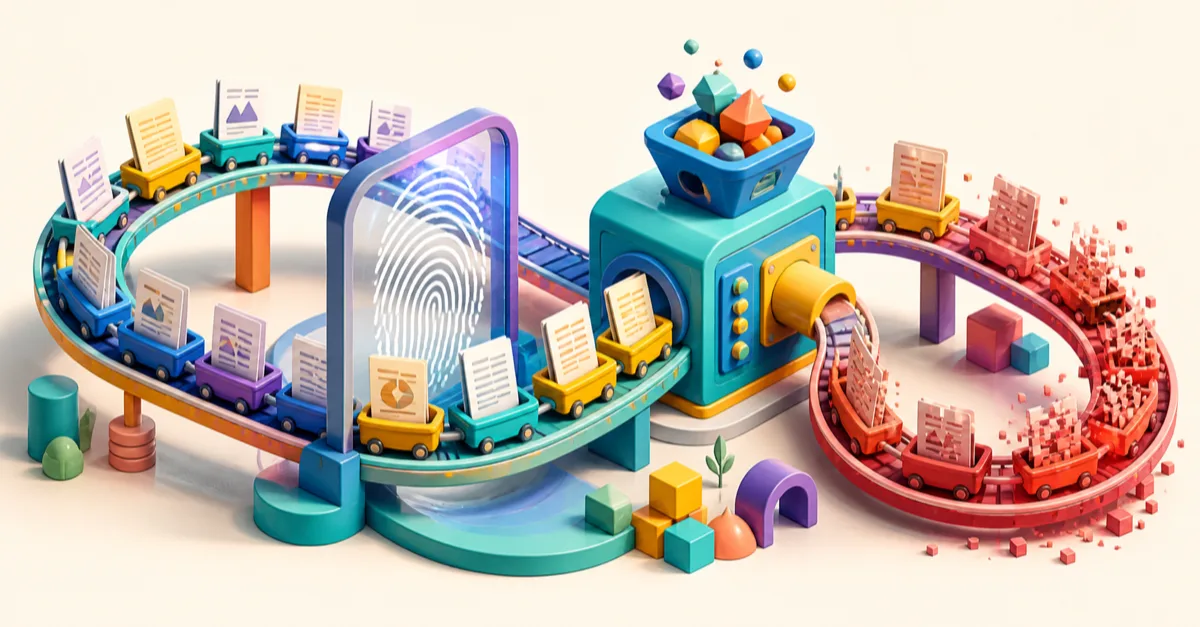
Das Web wird zugleich die Bibliothek, in der die KI-Systeme lernen, und der Raum, in den sie ihre eigenen Erzeugnisse schütten. Werden die kommenden Modellgenerationen unterschiedslos auf wachsenden Mengen synthetischer Inhalte trainiert, drohen sie ihre eigenen Näherungen zu wiederholen, bestimmte Fehler zu verstärken und nach und nach die Vielfalt zu verlieren, die in menschlichen Daten steckt.
Dieses Phänomen heißt Modellkollaps, englisch model collapse. Die in Nature veröffentlichten Arbeiten zum rekursiven Training zeigen, dass sich der Verfall nicht zuerst in spektakulären Fehlern äußert, sondern im stillen Verschwinden der seltenen Fälle: die Verteilung zieht sich um ihren eigenen Mittelwert zusammen.
Das Wasserzeichen als Werkzeug der Datensteuerung
In dieser Perspektive ändert das Wasserzeichen seine Natur. Es erlaubte Plattformen, Suchmaschinen und Erstellern von Datensätzen theoretisch, menschliche von synthetischen Inhalten zu unterscheiden und sie dann zu kennzeichnen, zu filtern oder anders zu gewichten.
Anders gesagt: eine Kennzeichnung, die heute ausgerollt wird, um eine Aufsichtsbehörde zufriedenzustellen, könnte morgen dazu dienen, die Ressource zu schützen, von der die ganze Branche abhängt, nämlich Trainingsdaten, deren Herkunft sich noch bestimmen lässt.
Was das Wasserzeichen nicht beweist
Dieser Nutzen bleibt allerdings mittelbar, und die Grenzen sollten ohne Beschönigung benannt werden.
- Kein Wasserzeichen verbürgt den Wahrheitsgehalt eines Inhalts; ein gekennzeichneter Text kann falsch sein, ein nicht gekennzeichneter kann zutreffen.
- Kein Wasserzeichen verbürgt, dass der Inhalt nach seiner Erzeugung unverändert blieb.
- Für Text bleibt die Technik besonders anfällig: eine Umformulierung oder eine Paraphrase kann genügen, um ein statistisches Signal zu stören.
- Metadaten können bei einer Umwandlung, einer Komprimierung oder beim Teilen auf einer Plattform verschwinden, die Dateien neu codiert.
Unmittelbare Folge: das Fehlen einer Kennzeichnung beweist keine menschliche Herkunft. Ein Ranking-System, das das Wasserzeichen als Beweis behandelte und nicht als Indiz, würde sich in beide Richtungen irren.
Drei Ebenen derselben Frage
Die Antwort auf die Ausgangsfrage lautet wahrscheinlich so. Wasserzeichen werden zuerst ausgerollt, um den Transparenzpflichten der KI-Verordnung zu genügen. Sie können sodann Suchmaschinen helfen, die Herkunft von Inhalten besser zu bestimmen. Und auf längere Sicht könnten sie dazu beitragen, künftige Modelle vor einer unkontrollierten Fütterung mit synthetischen Daten zu schützen.
Es ist also vielleicht keine Wahl zwischen Regulierung, Qualität des Webs und Überleben der Modelle. Es ist dieselbe Frage, auf drei verschiedenen Ebenen betrachtet: juristisch, informationell und technologisch.
Was das für ein Unternehmen bedeutet
Für eine Organisation, die Inhalte erzeugt oder nutzt, werden ab sofort drei Gewohnheiten nützlich.
- Die Herkunft der eigenen Korpora festhalten. Zu wissen, was in einem Dokumentenbestand von einem Menschen geschrieben, von einem Menschen geprüft oder von einem Modell erzeugt wurde, ist eine Steuerungsinformation, kein redaktionelles Detail.
- Kennzeichnung nicht mit Validierung verwechseln. Herkunft wird nachverfolgt, Wahrheit wird geprüft. Das sind zwei verschiedene Vorrichtungen mit zwei verschiedenen Verantwortlichen.
- Die menschlichen Daten bewahren. Die Archive aus der Zeit vor der generativen Welle, die internen Protokolle, der fachliche Schriftwechsel bilden einen Bestand, dessen relativer Wert steigt, während das öffentliche Web synthetischer wird.
Genau dieser Linie folgen wir in BrainDup: jede Antwort stützt sich auf benannte Quellen, und die Herkunft der aufgenommenen Dokumente bleibt durchgängig nachverfolgt. Um darüber zu sprechen, vereinbaren Sie einen Termin oder schreiben Sie uns.
Die Frage, die offen bleibt
Eine wesentliche Frage bleibt: sollen wir das Wasserzeichen als schlichten Hinweis auf die Herkunft ansehen, oder soll es auch ein Maßstab für Ranking, Auswahl und Training werden?
Die Antwort ist nicht nur technisch. Sie wird entscheiden, was morgen das Recht hat, woraus zu lernen.
Quellen und weiterführende Lektüre
- Europäische Verordnung über künstliche Intelligenz: amtlicher Text, insbesondere Artikel 50
- Darstellung und thematischer Zugang zur KI-Verordnung
- Anthropic: Claude text watermark, auf Englisch
- Liora: Grundlagen und Anwendungen des AI watermarking, auf Französisch
- Sean Goedecke: Grenzen und Anfälligkeit von Wasserzeichen auf Text, auf Englisch
- OpenAI: Content Credentials, C2PA und SynthID, auf Englisch
- Wikipedia: Modellkollaps bei künstlicher Intelligenz
- Nature: Wirkungen rekursiven Trainings auf KI-erzeugten Daten, auf Englisch
- AS3P (11. August 2026): « KI-Verordnung: wie BrainDup antwortet, Artikel für Artikel »