Palantir, Microsoft und Google veröffentlichen 2026 drei Architekturen für Unternehmens-KI, die ausdrücklich auf einer Ontologie beruhen. Fünfundzwanzig Jahre nach dem Gründungsaufsatz des semantischen Webs. Hier steht, warum diese Wende absehbar war, was sie technisch bedeutet und wie eine Umsetzung aussieht, die heute wirklich verfügbar ist.
1. Drei Signale, die zusammenfallen, in wenigen Monaten
Der Wortschatz der Plattformen hat sich geändert.
Palantir stellt die Ontology in den Mittelpunkt der AIP-Architektur. Die Dokumentation beschreibt sie als Modellierung der « Substantive » und der « Verben » der Geschäftsprozesse, in einer Form, die sowohl Menschen als auch Agenten lesen können, und kündigt eine Maschine an, die « Milliarden von Objekten abfragen, Zehntausende von Aktionen orchestrieren und fortlaufend Lernen aus Erfahrung einbinden » kann [1].
Microsoft führt in Fabric IQ ein Element Ontology ein, als Vorschau. Die amtliche Dokumentation ist eindeutig: die Ontologie « definiert die grundlegenden Geschäftsentitäten, die Beziehungen, die Eigenschaften, die Regeln und die Aktionen », und « die Agenten verstehen, welche Aktionen verfügbar sind und wie sie aufzurufen sind » [2]. Eine Schicht NL2Ontology übersetzt Fragen in natürlicher Sprache in strukturierte Abfragen.
Google Cloud dokumentiert den Fall Yahoo: eine agentische Plattform für den Medieneinkauf, gebaut auf zwei getrennten Graphen. Ein knowledge graph in Spanner Graph trägt die betriebliche Wahrheit, Produkte, Bestände, Verträge, Kontrollen der Steuerung, wobei die Regeln als versionierte Beziehungen eingeschrieben sind statt in der Anwendungslogik vergraben. Ein context graph in BigQuery Graph trägt eine Ontologie der Entscheidungsspur, also die prüfbare Herkunft jeder Abwägung des Agenten [3].
Drei Anbieter, drei Architekturen, dieselbe Grundeinsicht. Und eine Formulierung, die man sich merken sollte, die von Swapnil Patel (Yahoo): « In dem Maß, wie die Branche von Systemen der Erkenntnis zu Systemen des Handelns übergeht, verschiebt sich die Schranke autonomer KI von der Fähigkeit des Modells hin zu der Frage, ob ein Unternehmen dem vertrauen kann, was ein Agent ohne Aufsicht tut » [3].
2. Was diese Plattformen wiederentdecken, wurde 2001 bereits festgehalten
Nichts davon ist begrifflich neu.
Tim Berners-Lee, der Erfinder des Webs, hält im Mai 2001 in Scientific American, zusammen mit James Hendler und Ora Lassila, die Idee eines Webs fest, dessen Daten von Maschinen auslegbar sind. 2007 macht er den Ausdruck Giant Global Graph bekannt: nicht mehr ein Netz von Dokumenten, verbunden durch Verweise ohne Bedeutung, sondern ein Netz typisierter Fakten.
Der technische Unterbau, der daraus folgt, steht seit Langem fest: URI für die Identität, RDF für das Tripel Subjekt, Prädikat, Objekt, RDFS und OWL, um zu erklären, was es geben kann, SPARQL zum Abfragen. OWL wird 2004 Empfehlung des W3C, OWL 2 im Jahr 2009, zweite Ausgabe 2012.
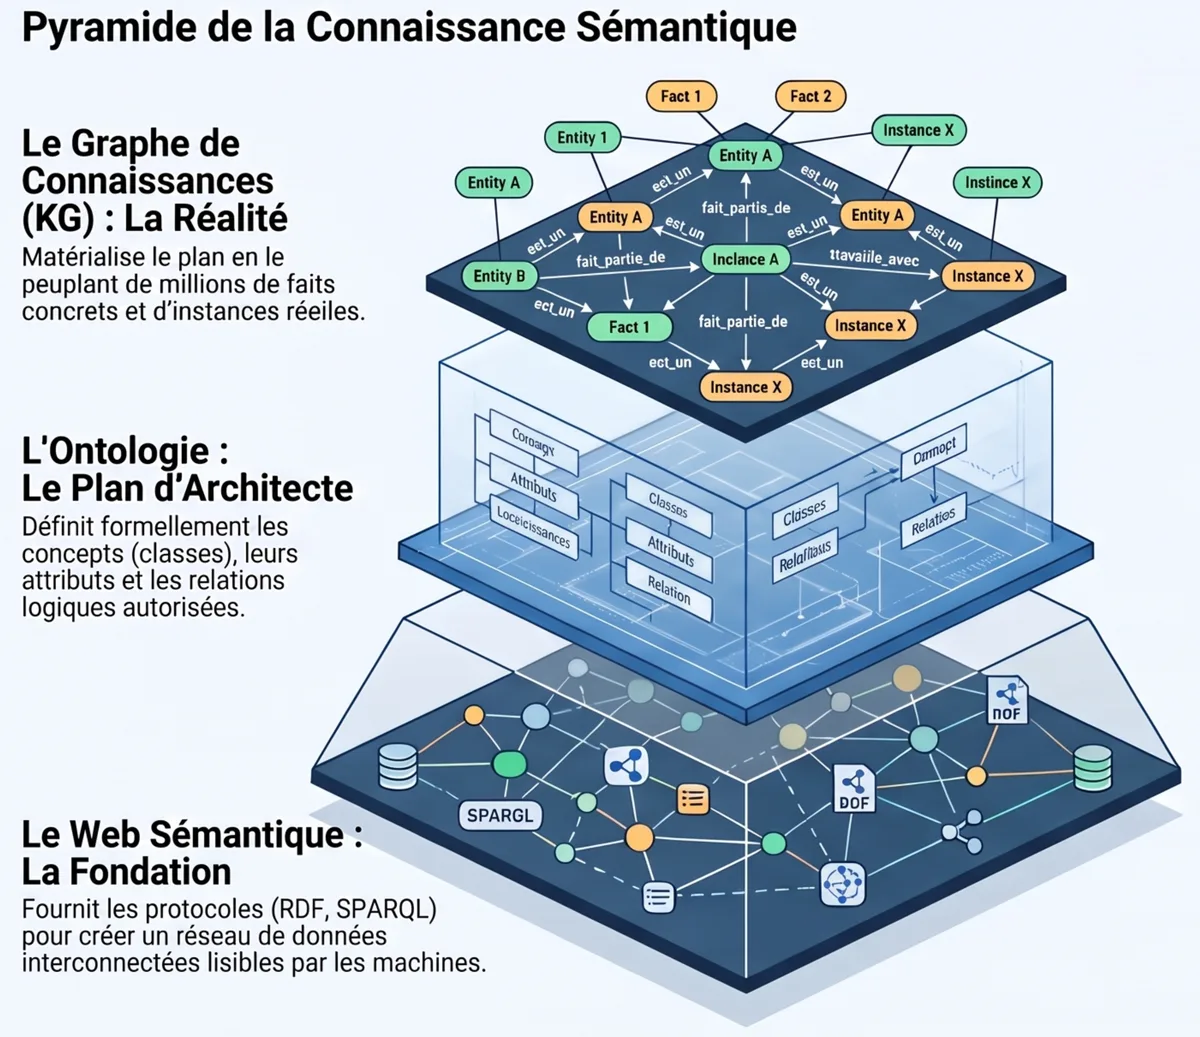
Auf der französischsprachigen Seite der Wissenstechnik legten Charlet, Bachimont und Troncy schon 2004 die Definitionen fest, die noch heute maßgeblich sind [4]. Zwei davon beleuchten die gegenwärtige Debatte unmittelbar:
« Eine Ontologie zu bauen heißt auch, über die Art und Weise zu entscheiden, wie die Gegenstände sind und bestehen. »
« Eine Ontologie ist eine Spezifikation, die teilweise Rechenschaft über eine Begriffsbildung ablegt. »
Dieses « teilweise » ist keine rhetorische Schwäche. Es benennt die ontologische Festlegung: den bewusst hingenommenen Abstand zwischen dem Deutungsreichtum eines Fachgebiets und dem, was eine berechenbare logische Theorie davon erfassen kann. Genau diese Frage stellt sich heute ein Architekt, wenn er entscheidet, welche Aktionen ein Agent ausführen darf.
Dieselben Autoren beschrieben schon damals den Bau von Ontologien aus Textkorpora, in vier Schritten, deren erster der Vorrang des Korpus und deren zweiter die semantische Normierung ist. Zweiundzwanzig Jahre später ist das genau die Verarbeitungskette, die erneut ausgerollt wird, mit einem statistischen Extraktor obendrein.
3. Warum jetzt: die LLMs lösen die wirtschaftliche Sperre und schaffen den Bedarf
Das historische Problem der Ontologie war nie ein theoretisches. Es war ein wirtschaftliches.
Eine Ontologie zu bauen verlangte einen Wissensingenieur und einen Fachexperten, auf einer langen Kette: die Begriffe bestimmen, die Klassen festlegen, die Hierarchie, die Beziehungen, die Einschränkungen, ausrichten, prüfen, pflegen. Zu teuer für die meisten Organisationen. Das Ergebnis: eine als hervorragend anerkannte Methode, die kaum angewandt wurde.
Die LLMs verschieben diese Sperre auf zwei entgegengesetzte und einander ergänzende Weisen.
Stromaufwärts senken sie die Kosten des Schreibens. Begriffe aus Text gewinnen, Entitäten und Beziehungen aus Text gewinnen, ein Schema entwerfen, eine erste OWL-Darstellung erzeugen: lauter Schritte, die nun unterstützt werden. Arbeiten aus den Jahren 2025 und 2026 messen diese Unterstützung an Sätzen von Kompetenzfragen, mit einem abgestuften Ergebnis: die Modelle decken mehr Fragen ab als Studienanfänger, erzeugen aber noch immer falsche Axiome und überflüssige Elemente. Die Unterstützung ist echt; die Prüfung bleibt menschlich und werkzeuggestützt.
Stromabwärts schaffen sie den Bedarf. Ein Sprachmodell hat kein stabiles Weltmodell. Vor den Dokumentenbestand eines Unternehmens gestellt, kann es Fragen nicht allein entscheiden, die gleichwohl die Struktur bestimmen: bezeichnet Konto ein Bankkonto oder ein Kundenkonto? Ist die Beziehung Kunde zu Konto 1:N oder N:N? Kann eine stornierte Bestellung noch eine Lieferung tragen? Darf ein Vertriebsmitarbeiter einen Vertrag ändern? Diese Antworten können nicht aus dem Vorwissen des Modells kommen. Sie müssen aus einer ausdrücklichen, geteilten und versionierten Erklärung kommen.
Und mit den Agenten ändert sich die Art des Einsatzes. Ein Gesprächsassistent, der sich leicht irrt, erzeugt eine falsche Antwort. Ein Agent, der sich leicht irrt, führt bestellung_stornieren(), geld_ueberweisen(), lieferant_wechseln() aus. Damit kehrt ein klassischer Gedanke der KI zurück: World Model plus Action Model.
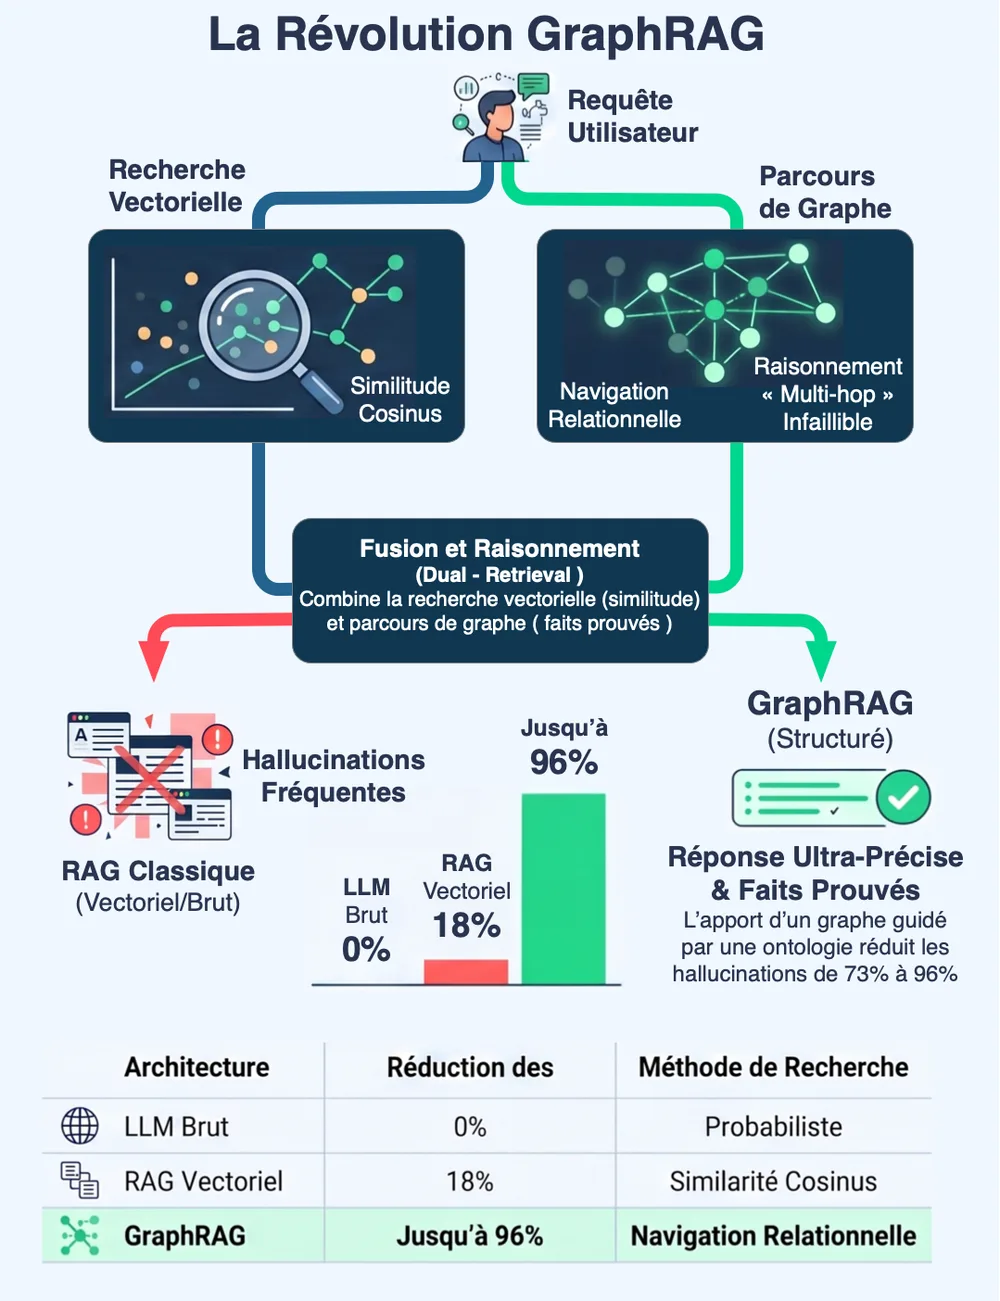
Ein Punkt verdient Nachdruck, denn er wird in den Netzen massenhaft verwechselt: GraphRAG ist keine Ontologie. Der voreingestellte Indexierungsablauf von Microsoft GraphRAG lässt ein LLM Entitäten und Beziehungen aus Text gewinnen, baut einen Graphen, erkennt hierarchische Gemeinschaften (Leiden) und erzeugt Gemeinschaftsberichte. Stromaufwärts ist keinerlei OWL-Ontologie erforderlich. Die richtige Formulierung lautet: GraphRAG gibt dem LLM einen Graphen; die Ontologie gibt diesem Graphen eine stabile Bedeutung.
4. Was das einer Architektur konkret abverlangt
Nimmt man die drei Beispiele aus Abschnitt 1 ernst, muss die semantische Schicht fünf Anforderungen erfüllen, nicht nur eine:
- Ein erklärter Wortschatz, vor der Aufnahme, in einem Standardformat, das ein Fachexperte nachlesen kann;
- Eine belastbare Grenze zwischen dem, was das Modell vorschlägt, und dem, was das System zulässt;
- Eine Versionsverriegelung: wissen, unter welcher Ontologie ein Datum erzeugt wurde und unter welcher Ontologie eine Antwort formuliert wurde;
- Eine prüfbare Herkunft der Entscheidung, getrennt vom Wissensgraphen selbst, das ist die Lehre aus dem Doppelgraphen von Yahoo;
- Eine Steuerung der Rechte, eingebaut in die Semantik, nicht nachträglich angefügt.
Das ist ein Lastenheft eines Architekten, kein Verkaufsargument eines Anbieters. Es lässt sich im Code nachprüfen, oder es lässt sich nicht nachprüfen.
5. BrainDup: dasselbe Modell, souverän, und bereits umgesetzt
BrainDup ist die KG-RAG-Basis, die AS3P entwickelt. Ihr Entwurf stammt aus der Zeit vor den Ankündigungen von 2026 und folgt genau derselben Linie. Die folgenden Punkte sind im Quellbestand nachprüfbar.
Die Ontologie steht in OWL, nicht in der Konfiguration. Jedes Fachgebiet wird in einer Turtle-Datei (TTL) beschrieben, die Klassen, Eigenschaften, Definitions- und Wertebereiche erklärt, dazu einen eigenen Satz von Anmerkungen (bdup:), der die Abbildung auf die Basis, die deterministische Identität und die Hinweise zur Extraktion trägt. Die allgemeine Basis POLE+O stellt fünf universelle Bausteine bereit, Person, Organisation, Ort, Ereignis, Objekt; die Fachpakete ersetzen sie nicht, sie spezialisieren sie über Mehrfachetiketten. Das Kulturerbe-Paket, im Betrieb auf einem Korpus von 921 Dokumenten der Regionalpresse, erklärt 19 Typen, 17 Beziehungen und 4 Ereignisarten, ausgerichtet an CIDOC CRM (ISO 21127) und RiC-O. Das Versicherungspaket beruht auf LKIF, ergänzt um die institutionelle Theorie (rohe Tatsachen gegenüber institutionellen Tatsachen, Instanzen, Regelungen, Dinge, sowie der Lebenszyklus einsetzend, folgend, beendend).
Die TTL wird kompiliert, nie im laufenden Betrieb ausgelegt. rdflib lebt im Build und tritt nicht in die Laufzeit ein. Das Kompilieren erzeugt ein JSON-Manifest, das ein geschlossener Vertrag prüft (extra="forbid" auf jeder Ebene): ein Schlüssel außerhalb des Vertrags wird nicht übergangen, er wird zurückgewiesen. Die Grenze zwischen dem Was zu gewinnen ist (vom Paket erklärt) und dem Wie (Schwellen, Verankerung der Textstellen, Mechanik der Ereignisse, gemeinsamer Code) wird strukturell und nicht mehr eine Frage der Übereinkunft.
Das Kompilieren ist eine Qualitätsprüfung, keine Umwandlung. Vier Familien sperrender Prüfungen gelten für die TTL: Bezeichner ohne Akzent, verpflichtendes französisches Label an jeder offengelegten Beziehung, Stimmigkeit von Definitions- und Wertebereichen, hängende Gleichsetzungen, Eigenschaft, die auf sich selbst zeigt, Instanzen außerhalb des erklärten Bereichs. Ein Paket, das durchfällt, wird nicht abgeschwächt, es wird nicht kompiliert. Und eine ohne Neukompilierung geänderte TTL lässt die fortlaufende Integration durchfallen, nie den Betrieb.
Das Paket wird bei der Geburt des Korpus verriegelt. Die aktive Ontologie ist kein Konfigurationsfeld, sondern ein INSERT-only-Journal in der Datenbank: der Zustand ergibt sich aus dem letzten Ereignis. Jede Aufnahmeaufgabe trägt die ontology_epoch, unter der sie in die Warteschlange gestellt wurde, und der Worker weigert sich, eine Aufgabe aus einer anderen Epoche zu bearbeiten. Ein SHA-256-Abdruck des Manifests wird beim Start verglichen: wurde das aktivierte Paket seither neu kompiliert, weigert sich der Prozess abzubilden, statt zwei Wortschätze in einem Graphen zu mischen. Das ist bewusstes fail-closed-Verhalten.
Die Antwortspur trägt die Ontologie. Jede erzeugte Antwort hält nicht nur die herangezogenen Textstellen, Entitäten und Beziehungen fest, sondern auch Kennung und Version der Ontologie, unter der der Prozess geantwortet hat. Das ist, auf der Ebene einer Dokumentenbasis, das Gegenstück zum context graph von Yahoo: die Herkunft der Entscheidung, getrennt vom Wissensgraphen.
Der leitende Grundsatz passt in einen Satz: das LLM schlägt vor, der Code entscheidet. Das Modell gewinnt aus Text und formuliert. Der deterministische Code entscheidet: eine Entität kommt nur dann in den Graphen, wenn sie einem vom Paket erklärten Typ entspricht und sich einer genauen Textstelle des Ausgangsdokuments zuordnen lässt. Die Belege setzt der Code aus dem Katalog zusammen, nie das Modell. Null gefundene Textstellen bedeutet eine ehrliche Verweigerung, ohne das LLM auch nur aufzurufen. Prosa ohne belegte Textstelle bedeutet ebenfalls eine Verweigerung.
Drei Datenbanken, ein einziger semantischer Vertrag. PostgreSQL trägt die transaktionale Wahrheit, die Rechte, die Versionen und die Prüfspur; Neo4j trägt den Graphen; Milvus trägt das vektorielle Gedächtnis. Das sind keine drei Silos, sondern drei Abbildungen desselben Vertrags. Die Rechte gehören dazu: Methode AGDLP, ein einziger Entscheidungsdienst, dann eigene Durchsetzung je Datenbank, Vorfilterung der Vektoren, im Graphen erzeugte Sicherheitsklauseln, Row-Level Security in SQL. Der Entzug eines Rechts wirkt sofort durch das Entfernen aus einer Gruppe, ohne Neuindexierung.
Das Ganze ist souverän. Lokale Inferenz, kein einziges Datum aus dem Korpus an Dritte, Souveränitätsprüfung fest in der Kette der fortlaufenden Integration verdrahtet, Betrieb auch in getrennter Umgebung möglich.
6. Tabelle der Entsprechungen
| Anforderung | Palantir AIP | Fabric IQ | Yahoo / Google | BrainDup |
|---|---|---|---|---|
| Erklärter Fachwortschatz | Ontology | Ontology (Vorschau) | Typisierte Graphontologie | Kompiliertes OWL/TTL-Paket |
| Aktionen und Regeln | Aktionen erster Klasse | Regeln und Aktionen | Regeln als versionierte Beziehungen | Geschlossener Vertrag plus Code-Wächter |
| Verankerung der Agenten | Ontology SDK | Strukturiertes Grounding, NL2Ontology | Spanner Graph | KG-RAG, Belege vom Code zusammengesetzt |
| Herkunft der Entscheidung | Fortlaufendes Lernen aus Erfahrung | Steuerung der Definitionen | Context graph, BigQuery | Abfragespur, mit der Ontologie gestempelt |
| Souveränität und Betrieb | Cloud des Anbieters | Cloud des Anbieters | Cloud des Anbieters | Lokal, souverän, abtrennbar |
7. Was BrainDup nicht tut, und warum wir es sagen
Die Glaubwürdigkeit einer Basis zeigt sich auch an den Zielen, die sie ausdrücklich nicht verfolgt.
BrainDup enthält keine OWL-Inferenzmaschine zur Laufzeit. Die transitiven Hüllen werden durch Ableitung im Code berechnet, ausdrücklich und prüfbar, statt an einen Reasoner abgegeben zu werden, dessen Verhalten von der Sauberkeit der Daten abhängt. Das ist eine Abwägung zwischen Ausdruckskraft und Vorhersagbarkeit, bewusst getroffen und dokumentiert.
BrainDup erhebt keinen Anspruch auf das weltweite semantische Web. Gegenstand ist ein privater Wissensgraph, begrenzt auf das Korpus einer Organisation. Berners-Lee zielte auf einen planetarischen Graphen; die Geschichte hat gezeigt, dass sich das semantische Web in Inseln verwirklicht hat, dort, wo Strenge lebenswichtig ist: Gesundheit, Recht, Finanzen, Kulturerbe, Industrie. BrainDup baut eine solche Insel, je Organisation.
Schließlich ist der Katalog der Fachpakete ungleich reif: zwei Pakete sind kompiliert und im Betrieb, acht weitere sind in TTL modelliert und warten auf ihren Durchgang mit Graphanmerkungen. Die verbleibende Arbeit ist Modellierung, keine Softwareentwicklung, und sie lässt sich beziffern.
8. Schluss
Der Verfasser des Aufsatzes, der diese Notiz veranlasst hat, schließt so: die Zukunft ist wahrscheinlich keine schlichte Rückkehr zu OWL, sondern eine semantische und betriebliche Schicht, die sich auf die Ontologie stützt und Fachmodelle, laufende Daten, Handlungsverträge, Regeln und Ausführungskontrollen verbindet; eine Art « semantisches Betriebssystem » zwischen den KI-Systemen und den Ressourcen des Unternehmens.
Das ist eine gute Beschreibung. Es ist zugleich, Wort für Wort, das, was eine gesteuerte KG-RAG-Basis heute schon umsetzt, in einem Maßstab, der nicht der eines Hyperscalers ist, sondern der eines Mittelständlers, einer Kanzlei, einer Gebietskörperschaft oder eines reglementierten Berufs.
Die Frage, die sich den Geschäftsleitungen 2026 stellt, lautet also nicht mehr « brauchen wir eine Ontologie ». Sie lautet: wem gehört die Ihre, wo läuft sie, und können Sie Abfrage für Abfrage nachweisen, unter welcher Version sie geantwortet hat?
Um diese Anforderungen an Ihrem eigenen Dokumentenbestand zu prüfen, vereinbaren Sie einen Termin oder schreiben Sie uns.
Quellen
- Palantir, AIP Architecture, Foundry Architecture Center. palantir.com
- Microsoft, What is Fabric IQ?, Microsoft Learn. learn.microsoft.com
- Google Cloud, Graph technologies underpin Yahoo's system of action, Juni 2026. cloud.google.com
- J. Charlet, B. Bachimont, R. Troncy, Ontologies pour le Web sémantique, Zeitschrift I3, Sonderheft semantisches Web, 2004, auf Französisch. HAL: hal-03854420
- T. Berners-Lee, J. Hendler, O. Lassila, The Semantic Web, Scientific American, Mai 2001; T. Berners-Lee, Giant Global Graph, 2007.
- W3C, OWL Web Ontology Language (Empfehlung 2004), OWL 2 (2009, zweite Ausgabe 2012).
- Überblicksaufsatz Why Ontology Is Making a Comeback in the Age of LLMs (2026), für die Verweise ESWC 2025, EMNLP 2025 (OG-RAG), ACL 2025 (ORT) und ACL 2026 (OntGQA).
Auch lesenswert
- Souveräne Unternehmens-KI: BrainDup bleibt bei Ihnen
- KI-Verordnung: wie BrainDup antwortet, Artikel für Artikel
- Mehrsprachiges multimodales RAG: warum Ihre KI Ihre deutschen Dokumente übergeht
Jean-Marc André, AS3P. BrainDup ist eine souveräne KG-RAG-Basis für Organisationen, die nachweisen können müssen, was ihre KI behauptet.